Wan 2.5 zwrócił uwagę twórców nie tylko jako kolejny model text-to-video. W analizowanych relacjach z testów najczęściej powtarzał się jeden motyw: możliwość opisania sceny, dialogu, efektów otoczenia i muzyki w tym samym poleceniu, a następnie otrzymania gotowego klipu z obrazem oraz dźwiękiem. Dla osób, które wcześniej osobno generowały film, lektora, efekty i synchronizację ust, taka zmiana może istotnie skrócić produkcję krótkiej sceny.
Nie oznacza to jednak, że każdy prompt daje od razu materiał gotowy do publikacji. Źródłowe artykuły są entuzjastycznymi relacjami autorów korzystających z konkretnego serwisu i konkretnej wersji modelu. Warto oddzielić ich obserwacje od aktualnej oferty dowolnego dostawcy, a jakość oceniać na własnym, powtarzalnym zestawie prób.
Co właściwie sprawdzano w Wan 2.5?
Autorzy źródłowych testów korzystali z dwóch głównych trybów: generowania filmu z tekstu oraz animowania obrazu. Próbowali prostych opisów, dialogów z emocją i akcentem, dźwięków wynikających z akcji, muzyki budującej nastrój oraz poleceń dla kamery. W przykładach pojawiały się między innymi zbliżenia, powolny odjazd kamery, ruch okrężny, ujęcie z ręki, przejście od detalu do szerokiego planu i boczne śledzenie obiektu.
Wnioski z tych prób można sprowadzić do czterech pytań:
- Czy ruch postaci i kamery pozostaje spójny przez cały klip?
- Czy mowa pasuje do ekspresji oraz ruchu ust?
- Czy efekty dźwiękowe rzeczywiście wynikają z obiektów i otoczenia?
- Czy model wykonuje polecenia filmowe, zamiast tylko poruszać statycznym obrazem?
Taki zakres jest bardziej miarodajny niż ocena jednego efektownego klipu. Pokazuje też, że udane generowanie audiowizualne wymaga osobnego planowania obrazu, głosu, przestrzeni dźwiękowej i pracy kamery.
Od niemego klipu do obrazu z dźwiękiem
W pierwszej szczegółowej relacji autor porównał wcześniejsze tworzenie filmu AI do prowadzenia dwóch oddzielnych studiów. Najpierw powstawał obraz, potem trzeba było przygotować głos, efekty, muzykę i dopasować ruch ust. Według jego testu Wan 2.5 potrafił wygenerować te warstwy w jednym przebiegu. Opisywał zsynchronizowany dialog, odgłos szklanej kuli uderzającej o stół oraz muzykę dobraną do deszczowej, melancholijnej sceny.
To ważna obserwacja, ale „w jednym przebiegu” nie znaczy „bez montażu”. Nadal trzeba sprawdzić, czy głos nie zmienia barwy, czy akcent jest zgodny z intencją, czy dźwięk ma właściwą perspektywę oraz czy muzyka nie zagłusza dialogu. Przy większym projekcie osobne ścieżki audio dają większą kontrolę, dlatego zintegrowany wynik najlepiej traktować jako mocny szkic albo gotowy krótki format — zależnie od jakości konkretnej generacji.
Trzy warstwy dobrego promptu dźwiękowego
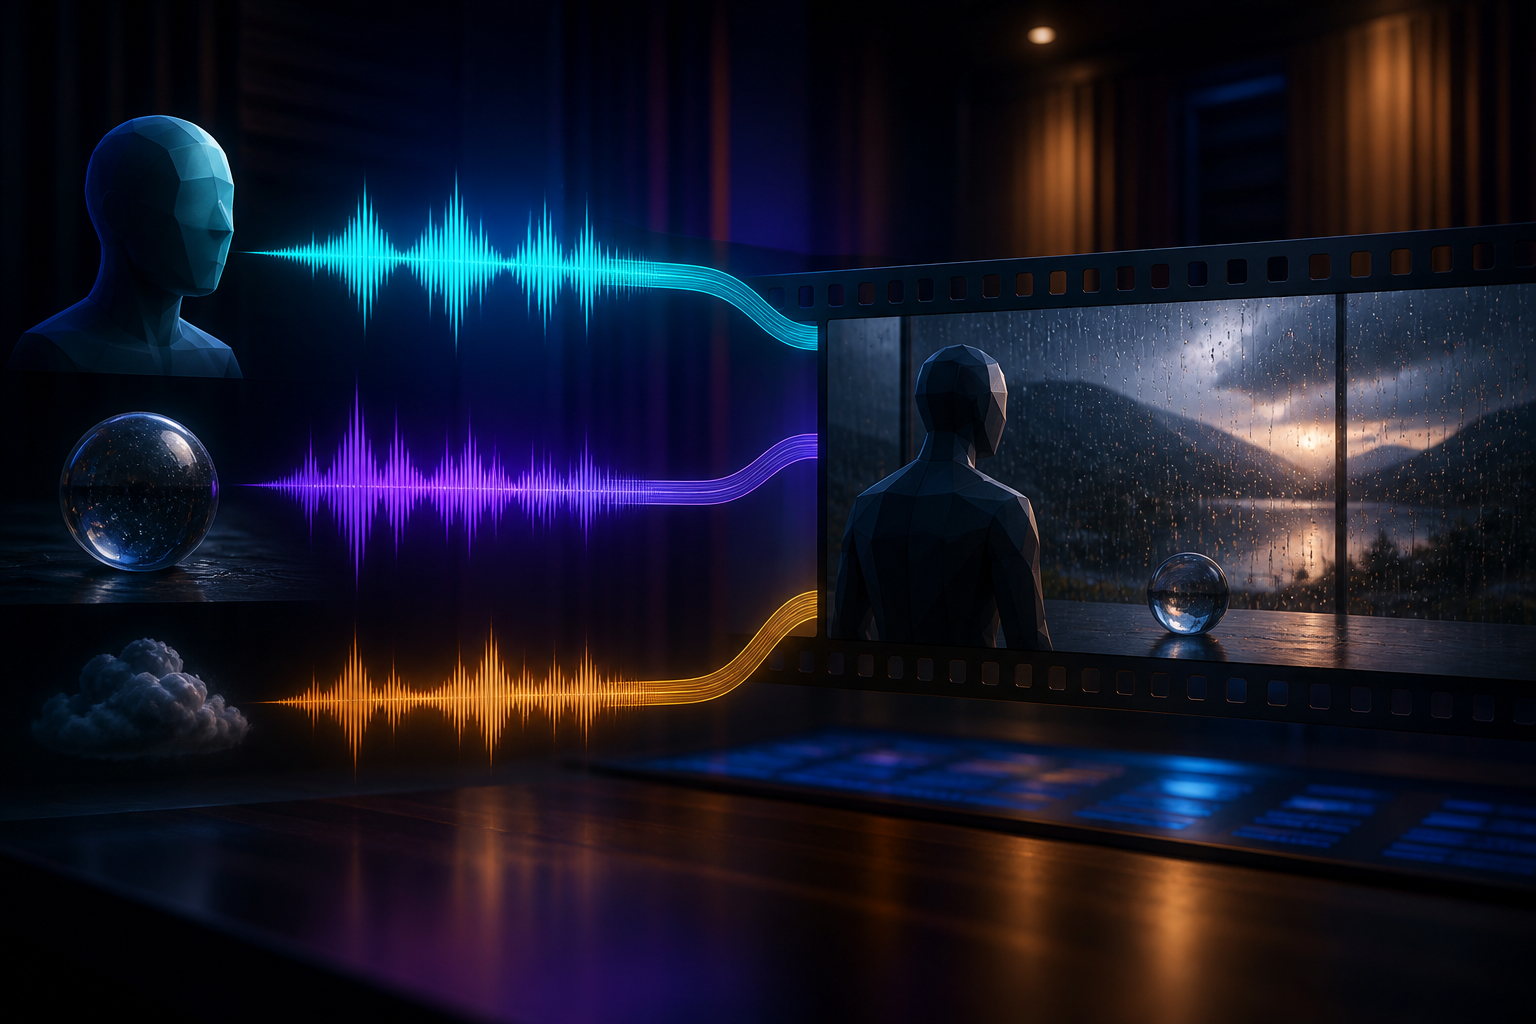
Najbardziej praktyczną częścią źródłowego poradnika są trzy proste schematy. Nie są to sztywne komendy, lecz listy elementów, które pomagają doprecyzować intencję.
1. Głos i dialog
Schemat z testu wyglądał tak: wypowiedź postaci + emocja + ton + tempo + barwa + akcent.
Zamiast pisać tylko „kobieta mówi, że pociąg odjeżdża”, można użyć opisu: „dorosła podróżna spogląda na zegar i mówi: «Musimy już iść»; głos spokojny, ale pilny, średnie tempo, ciepła barwa, naturalna polska wymowa”. Każdy składnik ma konkretne zadanie. Emocja wpływa na ekspresję, tempo na długość wypowiedzi, a barwa i akcent ograniczają przypadkowość głosu.
Dialog powinien być krótki względem długości ujęcia. Jeżeli zdanie nie mieści się w zakładanym czasie, model może przyspieszyć mowę, zgubić słowa albo osłabić synchronizację ust. Lepiej zacząć od jednej wypowiedzi i dopiero później rozbudowywać scenę.
2. Efekty dźwiękowe
Drugi schemat to: materiał + działanie + otoczenie.
Przykładowo: „ceramiczna filiżanka zostaje postawiona na drewnianym stole w cichej kawiarni”. Materiał sugeruje charakter uderzenia, działanie określa moment dźwięku, a otoczenie podpowiada pogłos i poziom tła. Samo „dodaj odgłos filiżanki” pozostawia zbyt wiele przypadkowych decyzji.
3. Muzyka tła
Trzecia formuła to: rodzaj muzyki lub partytury + styl i nastrój. Można napisać: „oszczędna partytura smyczkowa, melancholijna, powoli narastająca, bez dominowania nad dialogiem”. Warto opisać funkcję muzyki, a nie tylko gatunek. „Buduje niepokój przed wejściem postaci” jest bardziej użyteczne niż samo „muzyka filmowa”.
Język kamery, który model może zinterpretować
Drugi obszerny test skupiał się na roli „reżysera”. Autor zaczynał od pojedynczego zdania, a potem dodawał akcję, emocję, dialog i instrukcje kamery. Za szczególnie czytelne uznał polecenia takie jak „zbliżenie na oczy” oraz „kamera powoli się oddala”. Opisywał też poprawną interpretację powolnego najazdu, śledzenia w bok, szerokiego odsłonięcia sceny i lekkiego drżenia ujęcia z ręki.
Najlepszy prompt nie jest jednak katalogiem wszystkich ruchów naraz. Dobrze wybrać:
- jeden rozmiar planu na początku;
- jeden główny ruch kamery;
- jeden punkt, na którym ma skupić się uwaga;
- tempo ruchu;
- światło i paletę wspierające nastrój.
Przykład: „Półzbliżenie dorosłego zegarmistrza przy stole, chłodne światło poranka. Podnosi naprawiony zegarek i uśmiecha się z ulgą. Kamera bardzo powoli przesuwa się w prawo, zachowując ostrość na dłoniach. Cichy mechaniczny tik, delikatne odgłosy warsztatu, bez muzyki”. Jest tu postać, akcja, emocja, kompozycja, pojedynczy ruch i oszczędny dźwięk.
Jak testować Wan 2.5 krok po kroku
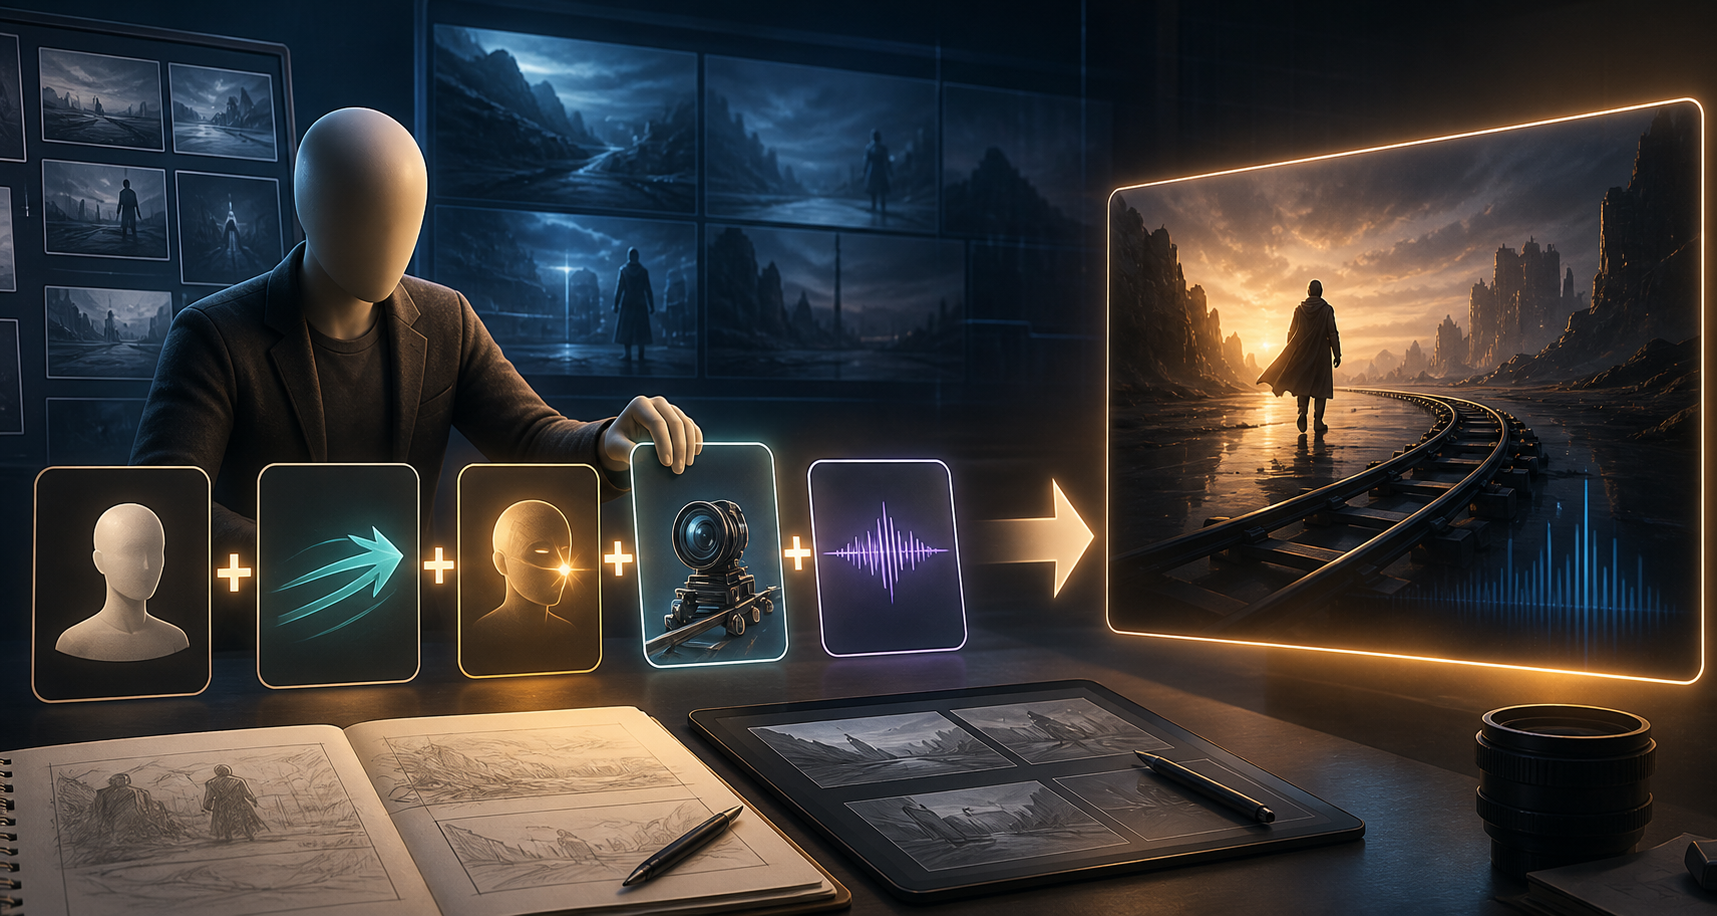
Rada powtarzająca się w relacjach brzmi rozsądnie: zacznij prosto i dodawaj po jednej zmiennej. Dzięki temu wiadomo, który element pomógł, a który zepsuł wynik.
Próba 1: sama scena
Napisz jedno zdanie z podmiotem, czynnością i miejscem. Nie dodawaj jeszcze dialogu, muzyki ani złożonej pracy kamery. Oceń anatomię, ruch, geometrię tła i utrzymanie wyglądu postaci.
Próba 2: emocja i styl wizualny
Dodaj nastrój, rodzaj światła oraz paletę. Porównaj wynik z pierwszą próbą. Sprawdź, czy styl nie zmienił tożsamości postaci lub fizyki sceny.
Próba 3: jedna instrukcja kamery
Wybierz najważniejszy ruch, na przykład spokojny odjazd. Jeżeli kamera skacze albo zmienia kierunek, uprość słownictwo i usuń konkurujące polecenia.
Próba 4: dialog lub efekt
Dodaj tylko jedną warstwę audio. Przy dialogu porównaj długość zdania z czasem klipu. Przy efekcie sprawdź jego moment, głośność, charakter materiału i zgodność z odległością od kamery.
Próba 5: muzyka i pełna kompozycja
Dopiero na końcu dodaj tło muzyczne. Zachowaj poprzednie wersje, aby rozpoznać regresję. Jeśli pełny prompt daje gorszy rezultat, wróć do ostatniego stabilnego wariantu zamiast losowo zmieniać wszystko.
Text-to-video czy image-to-video?
Tryb text-to-video daje większą swobodę kompozycji, lecz także większą zmienność. Sprawdza się do szukania pomysłu, ustawienia kadru i testowania języka kamery. Warto generować krótkie warianty i zapisywać parametry, zamiast oceniać model na podstawie jednego losowania.
W image-to-video zatwierdzony obraz wyznacza wygląd postaci, garderobę, kolory i układ sceny. Może to poprawić kontrolę wizualną, ale nie gwarantuje stabilności. Ruch może deformować dłonie, twarz, wzory lub krawędzie obiektów. Obraz startowy powinien być ostry, legalnie pozyskany i pozbawiony błędów, które animacja mogłaby wzmocnić.
W katalogu modeli wideo AI można porównywać dostępne rozwiązania, ale przed uruchomieniem zadania trzeba sprawdzić aktualne parametry wybranego modelu. Nazwa wersji nie wystarcza: dostawcy mogą stosować różne ustawienia, limity, formaty i sposoby rozliczania.
Jak czytać obietnice 5, 10 i 15 sekund, 1080p oraz „unlimited”
W jednej relacji autor napisał, że podczas jego prób dostępne były klipy 5-, 10- i 15-sekundowe, a rozdzielczość wzrosła z 720p do 1080p. To historyczny opis konkretnego dostępu, nie uniwersalna specyfikacja Wan 2.5. Długość, rozdzielczość, proporcje, czas kolejki i obsługa dźwięku mogą zależeć od hosta, planu, regionu oraz momentu testu.
Podobnie słowo „unlimited” w tytule jednej z recenzji jest określeniem marketingowym. Może oznaczać brak dziennego limitu, generowanie w ramach abonamentu, wolniejszą kolejkę po przekroczeniu puli albo zasady uczciwego korzystania. Przed zakupem należy przeczytać aktualny cennik i regulamin, sprawdzić koszt ponowień, znak wodny, prawa do eksportu oraz warunki komercyjnego użycia.
Lista kontrolna jakości gotowego klipu
Oglądanie filmu tylko raz w normalnym tempie łatwo ukrywa błędy. Dobry przegląd obejmuje:
- spójność czasową: czy twarz, ubranie, dłonie i tło nie zmieniają się między klatkami;
- ruch: czy ciężar ciała, kontakt z podłożem i bezwładność wyglądają wiarygodnie;
- kamerę: czy ruch ma jeden kierunek, właściwe tempo i stabilny punkt uwagi;
- mowę: czy usta, emocja, tempo i pauzy pasują do słów;
- efekty: czy dźwięk pojawia się dokładnie wtedy, gdy zachodzi akcja;
- przestrzeń: czy pogłos, głośność i tło odpowiadają miejscu oraz odległości;
- muzykę: czy wspiera scenę, ale nie zasłania wypowiedzi;
- koszt zaakceptowanego wyniku: ile prób, minut i kredytów wymagał klip nadający się do użycia.
Warto zapisywać prompt, ustawienia, czas oczekiwania i powód odrzucenia każdej wersji. Dopiero seria takich samych prób pozwala uczciwie porównać modele.
Ograniczenia, których efektowna demonstracja nie pokazuje
Krótkie przykłady źródłowe dobrze ilustrują potencjał, ale nie odpowiadają na wszystkie pytania. Nie wiadomo z nich, jak często potrzebne były ponowienia ani czy opublikowano najlepszy wynik z wielu prób. Brakuje też identycznego zestawu scen dla konkurencyjnych modeli, więc określenia w rodzaju „alternatywa dla Sora lub Veo” należy czytać jako opinię autorów, a nie wynik kontrolowanego benchmarku.
Trudniejsze przypadki to kilka mówiących osób, długi dialog, szybki ruch, zasłonięta twarz, dłonie pracujące przy małych przedmiotach oraz gwałtowna zmiana planu. W takich scenach błędy synchronizacji i ciągłości są bardziej prawdopodobne. Krótsze ujęcia z jednym bohaterem, jedną akcją i jednym ruchem kamery są lepszym punktem wyjścia.
Prawa, zgoda i przejrzystość
Generowanie realistycznego obrazu i głosu zwiększa odpowiedzialność twórcy. Korzystaj wyłącznie z materiałów, do których masz prawa, i z wizerunku oraz głosu pełnoletnich osób, które świadomie zgodziły się na konkretne użycie. Nie podszywaj się pod osoby publiczne ani prywatne, nie twórz fałszywych wypowiedzi politycznych, oszustw lub materiałów mających kogoś ośmieszyć.
Do publikacji oznaczaj treści syntetyczne, zachowuj dokumentację licencji i zgód, a przy muzyce lub głosie sprawdzaj zakres praw komercyjnych. Jeżeli klip może zostać pomylony z autentycznym nagraniem, sama techniczna jakość nie jest wystarczającym powodem, by go udostępnić.
Najczęstsze pytania o Wan 2.5
Czy Wan 2.5 zawsze tworzy dźwięk razem z filmem?
Analizowany test opisywał taki wynik w konkretnej implementacji modelu. Aktualna dostępność dźwięku zależy od serwisu, wersji i ustawień, dlatego trzeba ją potwierdzić przed generowaniem.
Czy dłuższy prompt daje lepszy rezultat?
Nie automatycznie. Dłuższy opis pomaga, gdy każda informacja ma jasną funkcję. Sprzeczne ruchy kamery, kilka akcji naraz i nadmiar przymiotników mogą obniżyć kontrolę.
Czy lepiej zacząć od tekstu, czy od obrazu?
Tekst jest dobry do eksploracji kompozycji. Obraz startowy jest lepszy, gdy liczy się konkretny wygląd, ale musi być wysokiej jakości i użyty zgodnie z prawem.
Czy 1080p oznacza profesjonalną jakość?
Rozdzielczość mówi tylko o liczbie pikseli. Nie naprawia niestabilnej anatomii, migotania, błędnego ruchu ust ani źle dopasowanego dźwięku.
Czy „unlimited” oznacza naprawdę nieograniczone generowanie?
Nie należy tego zakładać. Trzeba sprawdzić bieżący plan, zasady uczciwego użycia, prędkość kolejki i koszt dodatkowych funkcji.
Wniosek
Najciekawszym elementem Wan 2.5 opisanym w źródłowych testach jest połączenie obrazu, dialogu, efektów i muzyki z rozumieniem prostego języka filmowego. Najbardziej użyteczna lekcja nie brzmi jednak „napisz wszystko w jednym zdaniu”. Lepszy rezultat daje stopniowe budowanie sceny: najpierw stabilny obraz, potem emocja, jeden ruch kamery, jedna warstwa dźwięku i na końcu pełna kompozycja.
Entuzjastyczne demonstracje są dobrym punktem startu, lecz własny test powinien mierzyć spójność, synchronizację, liczbę ponowień, realny koszt i prawa do użycia. Wtedy Wan 2.5 można ocenić jako narzędzie produkcyjne, a nie tylko efektowną prezentację możliwości.