Charakterystyka modelu
Jev: Innowacyjne podejście do decyzji w aplikacjach
Zamiast tworzyć swobodne odpowiedzi, model Jev wymaga zdefiniowanego stanu, pytania oraz zestawu możliwych wyników.
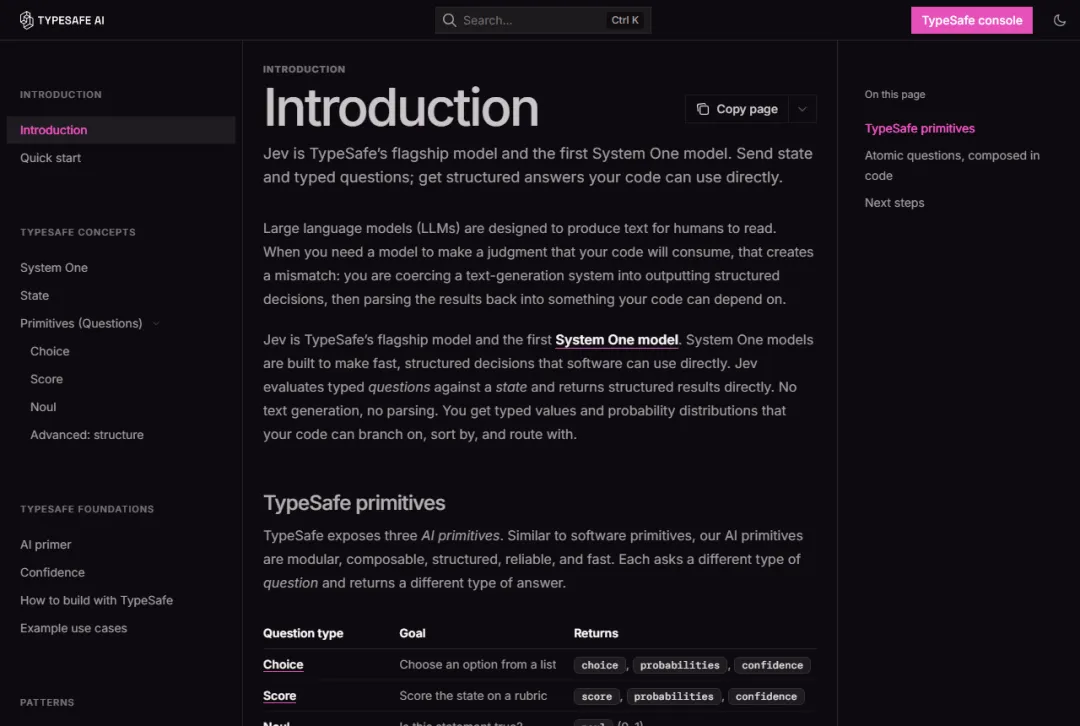
Jev to model System One, stworzony przez TypeSafe. Jego podstawowym zadaniem jest ocena warunków, wybór spośród predefiniowanych opcji lub punktacja według ustalonej skali. W rezultacie aplikacja otrzymuje ustrukturyzowany wynik, który może przetworzyć bezpośrednio, bez konieczności analizowania obszernych odpowiedzi tekstowych.
Artykuł Senzia zwraca uwagę na powtarzający się problem: wiele drobnych decyzji znacząco podnosi koszty i opóźnienia w funkcjonowaniu aplikacji. Przykłady takie jak wybór ruchu w grze, przypisywanie wiadomości do zespołów, weryfikacja komend czy dobór modelu do skomplikowanych zadań są świetnymi punktami wyjścia do testów, ale nie stanowią uniwersalnego dowodu przewagi w każdej implementacji.
Ten przewodnik uzupełnia listę zastosowań zaprezentowanych w materiale Senzia. Wszystkie opisane projekty, integracje i uzyskane wyniki są przypisywane oryginalnemu źródłu i nie są naszymi testami wydajności. Przedstawiamy praktyczne kryteria oceny oraz rozróżniamy model TypeSafe od niezależnych usług, które również używają nazwy Jev AI.
W VideoAny ten artykuł ma na celu przybliżenie architektury narzędzi AI. Nie potwierdzamy integracji modelu Jev z naszą platformą. Jeśli Twoim celem jest stworzenie gotowej grafiki lub klipu wideo, zalecamy skorzystanie z dedykowanych narzędzi do generowania obrazów i wideo, ponieważ sam klasyfikator nie tworzy tego typu materiałów.
Dane wejściowe i wyjściowe
Określanie weryfikowalnych zadań dla modelu
Poniższe przykłady przedstawiają strukturę projektu. Nie są one odzwierciedleniem rzeczywistych odpowiedzi API ani gotowych do wdrożenia progów produkcyjnych.
| Rodzaj decyzji | Przykładowe dane wejściowe | Oczekiwany rezultat | Weryfikacja w aplikacji |
|---|---|---|---|
| Noul: ocena stanu | Treść zapytania i kryteria pilności problemu | Ocena, czy zgłoszenie wymaga natychmiastowej interwencji | Zdefiniowany próg dla ocenionych zgłoszeń i procedura eskalacji |
| Choice: selekcja opcji | Opis problemu i odrębne kategorie wsparcia | Prawdopodobieństwo dla kategorii: konto, płatność, błąd, inne | Weryfikacja dostępności i kompetencji wybranego zespołu |
| Score: punktacja według skali | Dane wejściowe i definicja poziomów użyteczności | Wynik zgodny z określoną skalą oceny | Zestawienie z oceną ludzką i zarządzanie przypadkami konfliktowymi |
Poprawny format odpowiedzi nie zawsze oznacza trafną decyzję. Brak kluczowej opcji lub niekompletne dane wejściowe mogą prowadzić do błędnego wyboru.
Zastosowania praktyczne
Gry i nawigacja: szybkie decyzje w kontrolowanych środowiskach
Ta sekcja omawia zastosowania w grach i nawigacji. Przedstawia, jak wybierać kolejne działania na podstawie dostępnego stanu oraz jak oceniać rezultat całego zadania.
Doom. W demonstracji przedstawionej przez Senzia, Jev podejmuje decyzje dotyczące ruchu i akcji gracza, opierając się na aktualnym stanie gry. Dla dewelopera kluczowy jest szybki cykl: obserwacja, wybór dozwolonej akcji, jej wykonanie i ponowna obserwacja. Istotne jest ocenianie ogólnej efektywności rozgrywki i reakcji na opóźnienia, a nie tylko liczby podjętych decyzji. Ten przykład dotyczy środowiska gry.
Wikiracing. Model ma za zadanie dotrzeć z jednego artykułu Wikipedii do drugiego, używając wyłącznie dostępnych hiperłączy. To przykład semantycznego wyboru spośród wielu opcji. W podobnych zadaniach wyszukiwania rekomenduje się rejestrowanie odwiedzonych stron, zapobieganie zapętlaniu się oraz weryfikację faktycznego osiągnięcia celu. Link, choć tematycznie powiązany, może prowadzić do nieoczekiwanych rezultatów.
Subway Surfers. Materiał źródłowy opisuje jednoczesne prowadzenie wielu rozgrywek, w których Jev podejmuje szybkie decyzje o zmianie toru, skoku lub ślizgu. Ten przypadek podkreśla kwestię obciążenia: wiele sesji współdzieli infrastrukturę i budżet wywołań. Należy izolować stany poszczególnych gier, monitorować opóźnienia pod obciążeniem i upewnić się, że błąd w jednej sesji nie wpłynie na pozostałe.
Super Mario. W zaprezentowanym projekcie Jev steruje postacią, opierając się na stanie gry odczytywanym bezpośrednio z pamięci emulatora. Kluczowa jest tu reprezentacja danych: skondensowane informacje o pozycji, przeszkodach i możliwych ruchach mogą być bardziej efektywne niż próba interpretacji całego obrazu. Należy jednak dokładnie weryfikować poprawność odczytu stanu i odróżniać błędy modelu od błędów integracji.
Slay the Spire 2. W przykładzie paulwei klasyfikator wybiera działanie w strategicznej grze karcianej. Ograniczenie opcji do legalnych ruchów upraszcza problem, lecz nie usuwa długoterminowych zależności między decyzjami. Porównuj wynik całej partii, zużycie zasobów oraz spójność wyborów. Szybka reakcja na bieżący układ kart nie jest równoznaczna z dobrą strategią.
Wartości liczbowe dotyczące demonstracji gier, zaprezentowane w materiale Senzia, zależą od specyficznego środowiska testowego. Nie należy ich traktować jako gwarantowanych kosztów ani wskaźników wydajności dla innych implementacji.
Zastosowania praktyczne
Symulacje i grafika: nietypowe zastosowania selekcji
Symulacja jazdy, lądowanie rakiety oraz wybór koloru piksela pokazują, jak różnorodne problemy można sprowadzić do zestawu ograniczonych opcji.
Jazda w wirtualnym mieście. Materiał źródłowy prezentuje demonstrację, w której dane o drodze i stanie symulowanego pojazdu służą do wyboru kierunku. Kluczowym wzorcem jest tu ciągłe aktualizowanie stanu po każdej wykonanej akcji. Należy pamiętać, że taka prezentacja nie jest równoznaczna z systemem do prowadzenia rzeczywistego pojazdu; symulacje działają na kontrolowanych zasadach, podczas gdy realne środowisko wymaga innych mechanizmów niezawodności.
Lądowanie rakiety w MuJoCo. W opisanym eksperymencie Jev podejmuje decyzje dotyczące uruchamiania silników i modyfikacji konfiguracji lądowania. Dla projektanta kluczowe jest oddzielenie decyzji wysokiego poziomu od fizyki, sterowania i ograniczeń zaimplementowanych w symulatorze. Ważne jest dokumentowanie warunków początkowych oraz nieudanych prób, ponieważ pojedyncze udane lądowanie nie świadczy o odporności systemu na zmienne warunki środowiskowe.
Obraz składany z pikseli. Senzia wspomina o eksperymencie, w którym wybór koloru dla każdego kolejnego piksela jest traktowany jako decyzja z dostępnej palety. To interesująca demonstracja zastosowania klasyfikatora do zadań wizualnych, jednak nie potwierdza możliwości porównywalnych z typowymi generatorami obrazów. Koszt wynikający z wielu decyzji, spójność sąsiadujących pikseli oraz ogólna jakość kompozycji stają się odrębnymi aspektami wymagającymi oceny.
Ważne aspekty do weryfikacji
- W symulacjach należy rejestrować stan systemu przed podjęciem decyzji, dozwolone akcje oraz stan po ich wykonaniu.
- Oceniając eksperymenty z obrazem, skup się na ogólnej jakości grafiki, a nie tylko na poprawności wyboru pojedynczego koloru.
Zastosowania praktyczne
Automatyzacja przeglądarki: wybór akcji i elementów interfejsu
Materiał źródłowy analizuje projekt Browser Use jev-ultrafast oraz niezależną demonstrację wyszukiwania połączeń lotniczych.
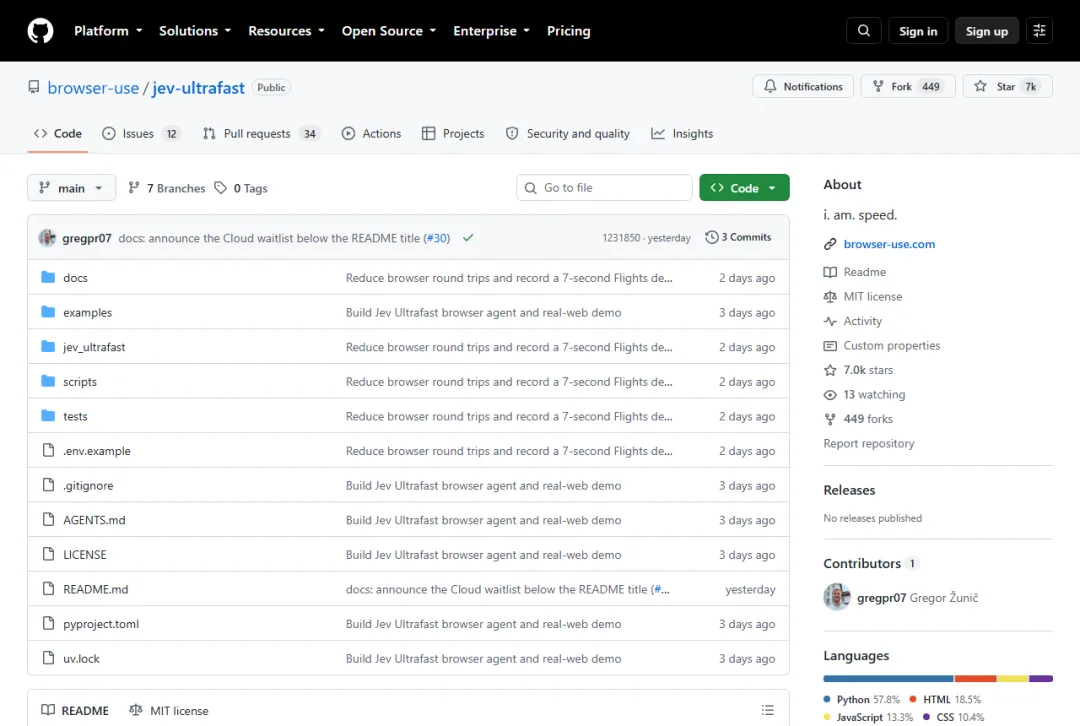
Browser Use jev-ultrafast. Senzia opisuje mechanizm, który dzieli operacje w przeglądarce na typ działania i jego obiekt. Zamiast oczekiwać swobodnego opisu interakcji, aplikacja dostarcza obserwowane elementy i dozwolone opcje. Jasne etykiety przycisków i aktualny stan strony są kluczowe. Jev podejmuje decyzję, natomiast narzędzie przeglądarkowe realizuje akcję i weryfikuje jej rezultat.
Wyszukiwanie lotu. Prezentacja Gregora Zunica pokazuje wypełnianie formularza linii lotniczej i przechodzenie do wyników wyszukiwania połączeń. Z tego przykładu warto wyciągnąć kryteria sukcesu: prawidłowe lotniska, data, kierunek oraz widoczne rezultaty. Samo kliknięcie przycisku wyszukiwania nie jest dowodem na sukces. Demonstracja wyszukiwania nie jest równoznaczna z dokonaniem rezerwacji ani potwierdzeniem ceny biletu.
Własne testy należy rozpocząć od procesów z jasno zdefiniowanym wynikiem i ograniczoną liczbą pól. Po każdej interakcji konieczne jest odczytanie aktualnego stanu, gdyż poprzednia lista elementów może być już nieaktualna. Oprócz czasu odpowiedzi modelu, należy mierzyć czas ładowania strony, liczbę ponownych prób i przypadki błędnie wypełnionych pól, ponieważ te czynniki często decydują o ogólnej użyteczności rozwiązania.
Materiał źródłowy podaje szybkość i koszt specyficznej demonstracji wyszukiwania lotów. Nie należy tych parametrów uogólniać na dowolną stronę internetową, sesję czy dostawcę usług.
Zastosowania praktyczne
Komendy, komunikacja i zarządzanie zgłoszeniami klientów
Ta kategoria obejmuje klasyfikator komend Vercel, zarządzanie pocztą korporacyjną, dystrybucję zgłoszeń, wstępną weryfikację zmian oraz obsługę pilnych reklamacji.
Klasyfikacja komend powłoki w Vercel. Według opisu Senzia, Jev zastąpił inny model w procesie oceny proponowanych poleceń. Kluczowa jest tu asymetria kosztów błędów: odrzucenie bezpiecznej komendy spowalnia pracę, natomiast akceptacja ryzykownej może prowadzić do uszkodzenia danych. Wynik klasyfikatora powinien wspierać reguły i procesy przeglądu, nie przejmując uprawnień wykonawczych ani nie zastępując mechanizmów izolacji środowiska.
Masowa klasyfikacja poczty firmowej. W porównaniu BryoAI, model identyfikuje intencję wiadomości, a system przypisuje ją do odpowiedniego procesu. W praktyce wymaga to zdefiniowania wzajemnie wykluczających się etykiet, rozpoznawania wiadomości wielowątkowych oraz dodania kategorii dla nierozstrzygniętych przypadków. Należy oceniać dokładność każdej kolejki oraz koszty korekt; niski koszt pojedynczego wywołania nie gwarantuje ogólnych oszczędności.
Automatyczne przypisywanie zgłoszeń. Jev może sugerować odpowiedni zespół spośród predefiniowanych opcji, bazując na kluczowych informacjach zawartych w zapytaniu klienta. Taki system jest łatwiejszy do weryfikacji niż otwarte polecenie obsługi klienta. Należy monitorować przepływ spraw między zespołami i aktualizować definicje kategorii wraz ze zmianami organizacyjnymi. Nietypowe zgłoszenia powinny być kierowane do ręcznej oceny.
Wstępna weryfikacja pull requestów. Materiał opisuje wykorzystanie listy zmodyfikowanych plików i wyników testów do kierowania zmian do odpowiedniego procesu przeglądu. Jest to przydatne narzędzie do selekcji uwagi recenzenta, jednak nie stanowi dowodu na poprawność kodu ani nie zwalnia z konieczności przeprowadzenia wymaganych testów. Decyzja o gotowości do scalenia zmian musi być również oparta na warunkach projektu i faktycznym stanie kontroli jakości.
Podwójne obciążenia i pilne reklamacje. Model może zidentyfikować zgłoszenia dotyczące powtórnych płatności lub wymagające szybkiej reakcji, kierując je do właściwej osoby. Klasyfikacja odnosi się do treści zgłoszenia, a nie potwierdza faktycznego błędu rozliczeniowego. Zwrot środków wymaga odrębnej weryfikacji transakcji i uprawnień; emocjonalny ton wiadomości nie powinien być jedynym wyznacznikiem priorytetu.
Ważne punkty do weryfikacji
- Oddzielnie analizuj błędne akceptacje, błędne odrzucenia oraz przypadki wymagające interwencji człowieka.
- Ograniczaj ilość przekazywanych danych klienta i zarządzaj listą dozwolonych akcji bezpośrednio w kodzie.
- Zmieniaj opisy kategorii, gdy zmieniają się procedury lub odpowiedzialność zespołów.
Zastosowania praktyczne
Agenci AI: zarządzanie dowodami, kontekstem i wybór modeli
Przykłady takie jak jev-mcp, fast-jev-compaction, Jev Codex Router, routing wejściowy i LangChain ilustrują organizację pracy w ekosystemie modeli generatywnych.
jev-mcp. Jak podaje Senzia, ten projekt społecznościowy oferuje oceny dotyczące zgodności twierdzeń z materiałem źródłowym, potencjalnych prób wstrzyknięcia instrukcji oraz trafności kontekstu. Skuteczna integracja powinna najpierw dostarczyć dowody, a następnie zapytać o konkretną relację między nimi a twierdzeniem. Model nie staje się niezależnym źródłem prawdy, a pojedyncza ocena nie zastępuje kompleksowych zabezpieczeń przed niepewną treścią.
fast-jev-compaction. Ten przypadek demonstruje ocenę użyteczności wyników narzędzi dla kolejnych etapów zadania oraz redukcję nadmiarowych informacji w kontekście agenta. Należy rozróżniać powtarzalne logi od decyzji użytkownika, komunikatów o błędach czy zmian w plikach. Podczas testowania porównuj stopień ukończenia zadania po kompresji, a usunięte dane przechowuj w formie umożliwiającej ich odtworzenie. Skrócony kontekst może okazać się mniej efektywny, jeśli utracone zostaną istotne szczegóły.
Jev Codex Router. Materiał źródłowy opisuje mechanizm wyboru modelu w zależności od złożoności zadania programistycznego. Koncepcja zakłada kierowanie prostych zleceń do tańszych wariantów, a bardziej skomplikowanych do zaawansowanych modeli. Ocena trudności może być niedokładna, dlatego projekt wymaga ponownej ewaluacji po niepowodzeniach, uwzględnienia rezerw budżetowych i pomiaru jakości finalnych zmian. Jest to opis zewnętrznego projektu, nie konfiguracja ani integracja VideoAny.
Routing na wejściu aplikacji. Inny przypadek z artykułu dotyczy decyzji, która usługa lub model powinny zostać uruchomione przed kosztownym procesem generowania. Kategorie mogą określać typ zadania, wymagane funkcjonalności i akceptowalny czas odpowiedzi. Należy porównywać całkowity koszt ścieżki, uwzględniając klasyfikator i ewentualne błędne przekierowania. W przypadku bardzo prostych i jednoznacznych warunków, wystarczająca może okazać się zwykła reguła zaimplementowana w kodzie.
Warstwa decyzyjna w architekturze LangChain. Senzia odwołuje się do materiału opisującego budowę środowiska agenta z użyciem Jev. Kluczową zaletą jest wyraźne rozdzielenie oceny stanu, wyboru narzędzia, wykonania akcji i weryfikacji rezultatu. Umożliwia to testowanie poszczególnych decyzji na zarejestrowanych przypadkach. Sam agent wciąż wymaga jednak implementacji obsługi błędów, zasad dostępu i kryteriów zakończenia zadania.
Nazwy projektów służą wyłącznie do identyfikacji przykładów przedstawionych w materiale źródłowym. Przed faktyczną integracją należy zweryfikować ich aktualne wsparcie i kompatybilność.
Analiza wyników
Testy rynkowe i zarządzanie niepewnością
Ostatnie przykłady z materiału źródłowego obejmują decyzje dotyczące księgi zleceń oraz test, w którym model może zrezygnować z rozstrzygnięcia niejednoznacznych przypadków.
Księga zleceń na blockchainie. Artykuł wspomina o eksperymencie, w którym decyzje podejmowane są na podstawie stanu rynku. Z inżynierskiego punktu widzenia jest to klasyfikacja strumienia szybko zmieniających się danych kontekstowych. Nie jest to dowód na rentowność, a prawidłowa etykieta nie uwzględnia automatycznie opóźnień wykonania, opłat transakcyjnych ani poślizgu. Traktujemy ten przykład wyłącznie jako ilustrację architektury, bez jakichkolwiek rekomendacji inwestycyjnych.
Benchmark PrimeLine. Senzia opisuje ewaluację, w której pomijanie odpowiedzi o najniższej pewności zmieniało wyniki porównania modeli. Praktyczny wniosek dotyczy metodologii pomiaru: obok dokładności należy podać, jaka część przypadków została obsłużona automatycznie. Poprawa wyników poprzez kierowanie trudniejszych spraw do człowieka jest łatwa, ale takie przekierowania generują własne koszty, które muszą być uwzględnione.
Pewność w wynikach typu Choice lub Score odzwierciedla koncentrację rozkładu prawdopodobieństwa modelu. Nie stanowi to zewnętrznego potwierdzenia prawdziwości ani gwarancji, że odpowiedź będzie równie trafna w nowej domenie. Kalibrację, progi eskalacji i zachowanie w przypadku brakujących danych należy ocenić na własnych, reprezentatywnych zbiorach danych. Wynik Noul ma odmienną strukturę i nie powinien być automatycznie utożsamiany z tym samym poziomem pewności.
Twój proces
Od inspiracji do weryfikowalnego testu: praktyczne kroki
Rozpocznij od pojedynczej decyzji, charakteryzującej się jasno zdefiniowanymi danymi wejściowymi, oczekiwanym wynikiem i oszacowanym kosztem błędu.
Wybierz zadanie, dla którego dostępne są przykłady ocenione przez ekspertów ludzkich, takie jak rozpoznawanie intencji zgłoszenia, wybór odpowiedniej kolejki czy wskazanie trafnego fragmentu. Precyzyjnie określ, jakie informacje model może przetwarzać, eliminując dane zbędne do podjęcia decyzji. Zdefiniuj odrębną ścieżkę dla kontekstu, którego brakuje, oraz dla przypadków wykraczających poza ustalone kategorie.
Porównaj model Jev z istniejącym rozwiązaniem, używając tych samych zestawów przypadków. Oprócz dokładności, rejestruj czas trwania całego procesu, liczbę ponownych prób, rozmiar danych wejściowych oraz koszt eskalacji. Analizuj błędy według kategorii, ponieważ uśrednione wyniki mogą maskować poważne problemy w kluczowych obszarach.
Początkowo uruchom proces oceny równolegle do dotychczasowego systemu, bez automatycznego wdrażania jego rekomendacji. Dopiero po dokładnej obserwacji będzie jasne, które decyzje mogą być automatyzowane przez aplikację, a które wymagają interwencji człowieka. Po każdej zmianie modelu, dostępnych opcji lub danych, powtórz testy, zamiast zakładać, że poprzednie progi nadal są aktualne.
Ważne punkty do weryfikacji
- Określ wzajemnie wykluczające się opcje oraz kategorię dla przypadków, które nie mogą zostać rozstrzygnięte.
- Weź pod uwagę przypadki niejednoznaczne, braki w danych oraz informacje wykraczające poza zdefiniowany zakres.
- Rejestruj każdą decyzję wraz z kontekstem, który umożliwi jej późniejszą weryfikację.
- Oddziel proces klasyfikacji od uprawnień, wykonania akcji i kontroli zakończenia zadania.
Pierwsze kroki
Dostęp, integracje i koszty: rozróżnianie usługodawców
Materiał źródłowy łączy informacje o modelu TypeSafe z sekcją FAQ niezależnej usługi o nazwie Jev AI.
Senzia wymienia konsolę TypeSafe, interfejs HTTP oraz biblioteki dla Pythona i JavaScriptu. Wspomina także o kanałach dostępu przez OpenRouter i Vercel AI Gateway. Są to aspekty, które należy zweryfikować u wybranego dostawcy przed integracją; nie można zakładać, że sama zmiana nazwy modelu zapewni identyczny format zapytań, odpowiedzi, limity czy zasady rozliczeń.
Wspomniany pakiet typesafe-ai/skills jest przeznaczony do pracy agentów z precyzyjnie sformułowanymi pytaniami. Jego użyteczna koncepcja polega na zgromadzeniu niezależnych niejasności i odpowiadających im opcji w jednym kroku. Nie oznacza to jednak, że każde zależne pytanie może być przetwarzane równolegle; niektóre decyzje wymagają wyników poprzednich działań.
Nie traktujemy cennika ze źródła jako aktualnej oferty. Opłaty producenta, stawki bramek dostępowych i kredyty niezależnych serwisów to odrębne systemy. Przed przystąpieniem do testów należy zweryfikować odbiorcę płatności, politykę przechowywania danych, limity, wersję modelu oraz metodologię naliczania zużycia. Koszt demonstracji nie odzwierciedla cennika Twojego konkretnego wdrożenia.
Podobne nazwy nie świadczą o powiązaniu usług. Jev to nazwa modelu TypeSafe, natomiast sekcja FAQ w cytowanym artykule opisuje również niezależny interfejs określany jako Jev AI. Nie przypisujemy obietnic kredytowych ani zasad API tego niezależnego serwisu ani producentowi modelu, ani VideoAny.
Często zadawane pytania
FAQ: Zastosowania modelu Jev
Czy Jev to typowy chatbot?
Jev jest przeznaczony do podejmowania ograniczonych, skategoryzowanych decyzji. Aplikacja dostarcza mu stan i pytania, a uzyskany wynik jest wykorzystywany do klasyfikacji, wyboru lub oceny. Generowanie swobodnych odpowiedzi, prowadzenie otwartych dialogów czy tworzenie treści nadal wymaga zastosowania modeli generatywnych.
Czy Jev tworzy obrazy i jest dostępny w VideoAny?
Eksperyment polegający na dobieraniu kolorów pikseli nie kwalifikuje Jev jako standardowego generatora obrazów. Nie potwierdzamy jego dostępności w VideoAny. Do tworzenia grafik możesz skorzystać z dedykowanego narzędzia tekst na obraz.
Od jakiego zastosowania najlepiej zacząć?
Zaleca się rozpoczęcie od powtarzalnej decyzji, która ma niewielką, jasno zdefiniowaną listę wyników i dla której dostępne są oceny ludzkie. Dobrym projektem testowym jest automatyczne przypisywanie zgłoszeń do zespołów. Na początek porównuj wyniki bez automatycznego wdrażania rekomendacji.
Czy wysoki poziom pewności gwarantuje poprawną odpowiedź?
Nie. Decyzja może być podjęta z dużą pewnością, lecz jednocześnie być błędna z powodu brakujących danych, niekompletnych opcji lub zmiany domeny. Progi pewności należy weryfikować na własnych zbiorach danych i łączyć z mechanizmem odraczania decyzji.
Czy podane w źródle wyniki szybkości i kosztów są gwarantowane?
Nie. Artykuł cytuje konkretne demonstracje i relacje ich twórców. Rzeczywisty koszt wdrożenia obejmuje także przygotowanie danych wejściowych, liczbę wywołań, infrastrukturę sieciową, narzędzia pomocnicze oraz koszty korekty błędnych decyzji.
Czy Jev może samodzielnie zatwierdzać komendy i zmiany w kodzie?
Klasyfikator może jedynie wskazać potencjalne ryzyko lub potrzebę przeglądu. Ostateczne uprawnienia, wymagane testy i reguły wykonania powinny pozostać w gestii aplikacji. Akceptowalna etykieta nie jest równoznaczna z autoryzacją do działania.
Czy Jev AI i TypeSafe to identyczne usługi?
Należy rozróżnić model Jev, stworzony przez firmę TypeSafe, od niezależnych serwisów, które również używają nazwy Jev AI. Wskazany artykuł sam dokonuje tego rozróżnienia w sekcji FAQ. Warunki konta, system kredytów i cennik należy zawsze weryfikować u konkretnego operatora usługi.
Kontynuuj czytanie
Odkryj modele i narzędzia VideoAny
Etap twórczy
Tworzenie gotowych obrazów i klipów wideo
Jev wspiera projektowanie decyzji w oprogramowaniu. Aby tworzyć materiały wizualne, skorzystaj z odpowiednich narzędzi VideoAny i dobierz model najlepiej pasujący do Twojego zadania.
- Sformułuj opis obrazu i wybierz odpowiedni model dostępny w studiu VideoAny.
- Dokładnie oceń wygenerowaną grafikę, zanim użyjesz jej jako elementu do stworzenia wideo.
- Zapoznaj się z warunkami użytkowania wybranego narzędzia przed rozpoczęciem większego projektu.